引言
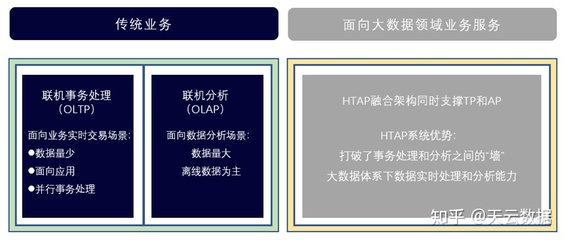
在数字化时代,企业对数据处理的需求日益增长,既要支持高并发的在线事务处理(OLTP),又要进行复杂的在线分析处理(OLAP)。传统上,这两种负载由不同的系统承担,导致数据延迟和架构复杂。Google F1作为全球首个真正意义上的HTAP(混合事务/分析处理)数据库,开创了在单一系统中同时支持事务和分析负载的先河。本文将深入剖析F1的架构设计,探讨HTAP数据库的诞生背景、技术挑战以及数据处理与存储支持服务的关键作用。
1. HTAP数据库的背景与需求
随着业务实时性要求的提升,企业希望在事务数据产生的同时进行分析,以支持实时决策。传统OLTP数据库(如MySQL) optimized for short transactions,而OLAP数据库(如数据仓库) optimized for complex queries。这种分离导致ETL延迟、数据不一致和高成本。HTAP概念应运而生,旨在打破OLTP与OLAP的界限,实现实时数据分析和事务处理的一体化。
2. Google F1的架构设计
Google F1最初构建于Spanner之上, later evolved into a standalone system. F1的核心创新在于:
- 分布式SQL引擎:支持事务一致性,通过Paxos复制实现高可用。
- 混合存储层:使用Spanner作为存储后端,提供强一致性和全局事务。
- 并行查询执行:利用分布式架构,将查询分解为多个子任务并行执行。
- 数据分区与索引:支持水平分区和覆盖索引,优化事务和分析查询。
F1的架构包括三个主要组件:
- F1 Master:管理元数据和负载均衡。
- F1 Server:执行SQL查询和事务。
- F1 Storage:与Spanner交互,存储数据。
3. HTAP的技术挑战
实现HTAP面临诸多挑战:
- 资源隔离:事务和分析负载相互干扰,需要有效的资源管理。
- 数据一致性:在分析查询的同时进行事务更新,保证快照隔离。
- 查询优化:针对混合负载的优化器设计,平衡延迟和吞吐。
- 存储引擎:支持行式和列式存储以提高分析性能。
F1通过以下方式应对:
- 多版本并发控制(MVCC):提供一致性快照,避免读写冲突。
- 分布式执行:将分析查询下推到存储层并行处理。
- 弹性资源:动态分配资源给事务或分析负载。
4. 数据处理与存储支持服务
数据处理和存储支持服务是HTAP数据库的基石。F1依赖以下技术支持:
- Spanner:提供全球分布、强一致的存储服务,支持事务。
- Colossus:下一代分布式文件系统,作为底层存储。
- 计算下推:在存储节点执行过滤和聚合,减少数据传输。
- 数据编码:高效的行列混合存储格式,如Proto2和列式压缩。
这些服务确保了F1能够同时满足低延迟事务和高吞吐分析的需求。
5. 对其他HTAP数据库的影响
F1的成功启发了众多HTAP数据库,如CockroachDB、TiDB、OceanBase等。它们借鉴了F1的架构思想,并结合自身场景进行创新。例如,TiDB采用TiKV作为存储层,TiFlash作为列式存储副本,实现HTAP。
6. 未来展望
随着云原生和AI技术的发展,HTAP数据库将进一步演进:
- 智能化负载管理:利用机器学习自动优化资源分配。
- 更紧密的存储计算分离:提升弹性和成本效益。
- 多模数据处理:支持JSON、图、时序等数据类型。
结论
Google F1作为HTAP数据库的先驱,展示了在单一系统中同时处理事务和分析的可行性。其架构设计和数据处理与存储支持服务的创新,为后续HTAP系统奠定了基础。随着技术的不断成熟,HTAP数据库将成为企业实时数据平台的核心。